平时工作时,一封邮件发不出去,可能只是自己的网络出了问题。
但如果政府部门、学校、银行、航运公司和跨国企业同时发现Outlook收不到邮件、Teams连不上会议、Microsoft 365打不开,那问题显然已经不在一台电脑上了。
11月12日,美国微软Microsoft 365发生近年来影响范围非常大的一次全球服务故障。Outlook、Exchange Online、Teams、SharePoint、OneDrive以及Microsoft Copilot等多个云端服务陆续出现连接失败、邮件延迟或者无法登录等情况。
故障最初在美国东部时间12日中午前后开始明显扩大,随后一路影响到欧洲和亚太地区。Downdetector统计显示,至少74个国家出现相关用户报告,Outlook单个平台一度在短时间内涌入接近13万条故障报告。
这场事故持续超过一天才逐渐恢复。
由于Microsoft 365早已成为政府、学校和大型企业日常工作中最基础的一套数字工具,这次故障也迅速从“邮箱打不开”,演变成一场跨行业的全球办公中断。
一、最先出问题的是Outlook,随后整个Microsoft 365生态都开始不稳定
11月12日中午,美国用户首先大量报告Outlook无法连接邮箱。
有人打不开收件箱,有人虽然能够登录,却无法发送和接收新邮件,还有用户发现刚刚发送的邮件长时间停留在队列中。
很快,影响范围扩大到其他Microsoft 365服务。
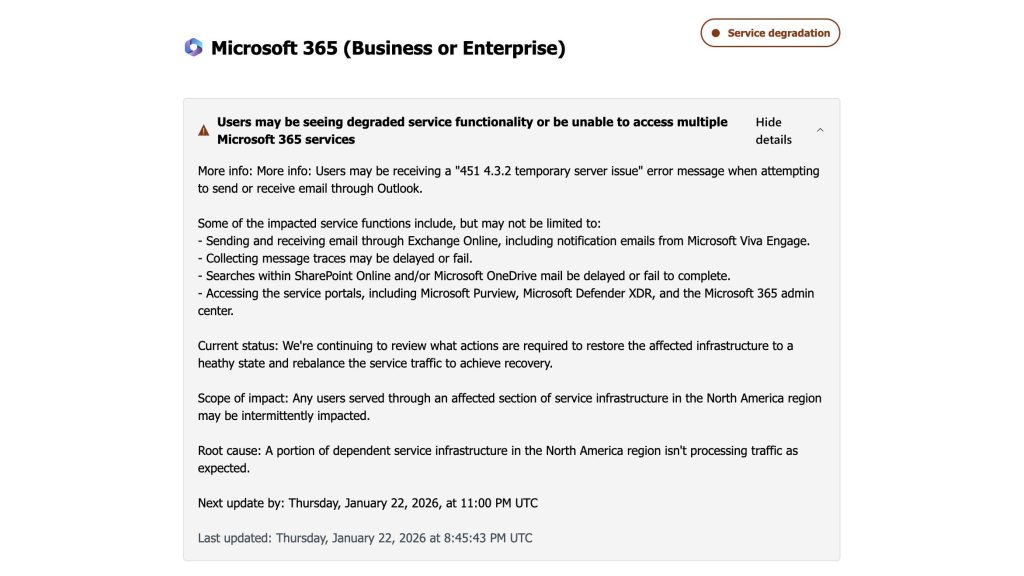
根据微软当时公布的服务状态,受影响范围包括Exchange Online、Microsoft 365应用、Teams、SharePoint Online、Microsoft Copilot以及Microsoft Defender XDR等企业级产品。
这意味着问题不只是“Outlook邮箱坏了”。
不少公司的文件存在SharePoint和OneDrive,会议依赖Teams,内部聊天、日历安排和Copilot又与Microsoft 365账号紧密连接。一旦底层云服务出现问题,原本看似独立的办公工具就会同时受到牵连。
路透社报道,在美国故障高峰期,Downdetector一度记录到超过9.7万条Outlook问题报告、3.8万多条Microsoft 365报告以及约4500条Teams报告。需要注意的是,这些数字代表用户提交的故障报告,并不是实际受影响人数,真正受到影响的用户规模可能远远更大。
二、美国国会工作人员也中招:日历、老板行程全在Outlook里
这场故障很快进入美国政府部门。
美国众议院工作人员确认,他们同样无法正常使用Microsoft Outlook。
有国会工作人员向媒体形容,Outlook几乎就是每天工作的“生命线”,因为不仅个人邮件在里面,自己的日历、议员老板的日程以及大量内部安排也都依靠这套系统。
一旦邮箱和日历同时停止工作,办公室很多日常流程就只能停下来或者改用其他方式处理。
美国地方政府也出现类似情况。
例如罗得岛州部分州政府、市政府和警察部门一度无法访问邮箱。一些机构只能利用社交媒体向公众说明情况,或者要求居民改用电话联系。
这种影响并不像停电那样让整个政府停止运转,却暴露出一个非常现实的问题:很多办公室虽然看起来使用几十种软件,真正承担核心沟通的工具其实高度集中在同一个云平台上。
三、英国医院、警察、学校也受影响,但紧急服务没有停止
到了11月13日,英国政府确认Microsoft 365故障已经影响到当地公共部门。
英国议会随后专门就事故作出说明,表示11月12日至13日的Microsoft系统中断影响了个人、企业以及公共部门,其中包括医疗和其他公共服务。
不过,英国政府同时强调,999紧急电话等关键服务一直保持运行,没有出现大规模关键基础服务中断。
伦敦地区受到影响的机构包括Metropolitan Police、London Fire Brigade、议会、英国最高法院、部分NHS医疗机构以及学校。
有些医疗工作人员一度需要使用纸质记录或者备用沟通方式继续工作。
英国国家档案馆也公开发布公告,称Outlook全球故障影响到了Freedom of Information信息公开申请、军事记录申请、文件复制以及普通咨询等多项服务,并建议公众暂时不要发送非紧急申请,避免邮件丢失或者延迟。
四、澳大利亚一些学校直接停掉在线课程
对于教育系统来说,这次事故的影响尤其直观。
澳大利亚北领地教育部门表示,当地多所学校因为全球Microsoft服务故障出现技术问题,并提醒家长如果需要联系学校,暂时不要依赖电子邮件,而应该直接打电话。
一些原本高度依赖远程教学的学校受到的影响更明显。
澳大利亚ABC报道,Longreach School of the Air因为Microsoft服务无法正常运行,一度直接取消线上课程。
这种学校服务的很多学生居住在偏远农场和牧场,本来就主要通过互联网接受教学,因此一旦远程课堂平台和邮件系统出问题,传统的“改成面对面上课”并不是现实选择。
这也说明,类似云端故障对于普通学校可能只是暂时收不到邮件,对于远程教育机构却可能直接意味着一天课程无法正常进行。
五、日本政府一度无法收发邮件,紧急事务改成打电话
微软故障一路蔓延到亚洲以后,日本政府部门也受到明显影响。
日本外务省11月13日公开表示,由于Microsoft 365发生大规模服务故障,外务省当时已经无法正常发送或接收邮件。
官方因此要求,有紧急事务的人直接通过电话联系相关部门。
日本驻纽约总领事馆随后也发布提醒。
虽然签证和领事预约等核心信息系统没有确认受到影响,但故障期间发送的申请和咨询邮件可能没有正常送达。因此,如果属于紧急事务,或者等待数日仍然没有收到回复,应该通过电话重新联系。
这类情况可能也是此次事故最麻烦的地方之一。
系统恢复并不代表故障期间的所有邮件会瞬间全部出现。大量信息仍需要在服务器队列中重新处理,所以即使用户已经能够重新登录Outlook,也可能继续遇到邮件迟到的问题。
六、全球航运巨头Maersk也受影响,客户通知出现延迟
企业方面,全球大型航运公司A.P. Moller-Maersk很快发布公告,确认Microsoft服务故障正在影响自己的部分通信系统。
Maersk特别说明,问题来自Microsoft,并不是Maersk内部IT系统自身发生故障。
但因为公司的日常通知、电子邮件和客户更新大量依赖Microsoft服务,因此部分信息可能出现延迟或者短暂中断。
对于航运行业来说,电子邮件并不只是普通办公室沟通。
船期、货物状态、码头安排、报关文件以及客户确认等大量信息都需要及时传递,因此即使核心运输系统没有停止,一旦通信渠道中断,也可能给实际业务带来明显麻烦。
Maersk因此建议遇到紧急情况的客户直接拨打当地办公室电话。
这一天,传统电话反而成了不少大型机构最可靠的备用工具。
七、欧洲交易所没停交易,但部分客户只能改用电话联系
欧洲主要证券交易所运营商Euronext同样受到影响。
11月13日,Euronext公开表示,由于Microsoft Outlook发生故障,其部分Corporate Actions和Listing团队无法正常接收电子邮件。
公司因此要求涉及停牌、公司行动、大股东申报等紧急事务的上市公司和代理机构,不要继续等待邮件回复,而是直接通过电话联系交易所人员。
值得注意的是,故障并没有导致Euronext证券市场本身停止交易。
Euronext Securities也表示,其核心系统保持正常运行。
这也是理解这次事故影响范围的一个重要区别。
“Microsoft 365出故障”并不等于使用微软产品的所有公司都全面停摆。
很多企业真正受到影响的是邮件、文档、会议和内部通信,而自己的交易、生产或者专业业务系统仍然可以继续运行。
八、ChatGPT和Claude确实被波及,但并不是AI服务整体崩了
这次事件还有一个很有意思的连锁反应:连一些并不属于Microsoft的AI平台也受到影响。
OpenAI在11月12日发布服务状态公告,确认Microsoft 365连接器出现异常。
用户可能无法建立新的Microsoft连接,而已经连接的邮件、文件等工具也可能无法正常工作。OpenAI随后于11月13日晚宣布该问题已经恢复。
Anthropic的Claude也发生类似情况。
Claude官方状态页面显示,Microsoft 365 connector中的邮件、日历、搜索以及部分Teams和SharePoint请求出现大量错误,Claude for Outlook同样受到影响。
Anthropic明确指出,这次故障是由Microsoft 365上游服务事故造成的。
这里需要特别区分:
ChatGPT和Claude本身并没有因为Microsoft宕机而整体无法使用。
真正受影响的是那些需要从Microsoft 365读取Outlook邮件、日历、Teams聊天或者SharePoint文件的功能。
这正好说明了现在AI工具之间越来越复杂的依赖关系。
AI本身服务器可以完全正常,但如果它需要调用的第三方数据源出了问题,最终用户看到的仍然是“这个功能不能用了”。
九、微软确认不是黑客攻击,真正的问题出在服务器和网络基础设施
发生如此大范围的全球故障以后,外界自然很快开始猜测是否与黑客攻击有关。
微软随后明确表示,目前没有迹象显示事故由恶意或者网络攻击活动造成。
微软早期调查发现,部分服务器突然无法通过自动健康检查而被判定不可用。
随着越来越多服务器退出服务,剩余基础设施承担的压力迅速增加,从而造成连接失败。
微软工程团队随后暂停部分系统部署,并开始重启受影响服务器,同时把流量转移到其他基础设施。
问题比最初想象的更加棘手。
一些重新启动的服务器刚恢复正常,一旦重新接收用户流量又会变得无响应,因此微软不得不限制部分流量,并逐步恢复服务,而不是一次性把所有服务器重新放回线上。
微软后来提供的初步原因进一步指向网络基础设施:此前一次network capacity upgrade,也就是网络容量升级中存在的问题,在之后一次网络配置变更后被触发,最终导致此次大规模服务异常。
所以这并不是有人突然向微软发动大规模攻击,而更像是一连串底层基础设施问题产生的连锁反应。
十、恢复最麻烦的不是“重新登录”,而是把堆积的邮件全部送出去
到了11月13日,微软已经开始看到比较明显的恢复。
北美、欧洲和亚太地区陆续有更多用户重新取得邮箱和Microsoft 365访问权限。
但邮件系统有一个特殊问题:服务恢复以后,故障期间已经发送的大量邮件并不会全部瞬间到达。
这些邮件会形成庞大的等待队列。
微软因此把重点之一放在处理邮件积压,并表示邮件队列正在明显减少、逐渐接近正常水平。
这也是为什么一些用户会遇到一种奇怪情况:
Outlook已经可以打开了,但几个小时甚至一天前发送的邮件才陆续出现在收件箱中。
Microsoft还采取措施延长部分邮件的超时时间,避免因为服务器长时间无法投递而把邮件直接判定失败。
对于政府、企业和学校来说,这种延迟甚至比单纯几个小时打不开邮箱更加麻烦,因为用户很难立即判断哪些信息已经成功发出,哪些仍然卡在服务器上。
十一、这次故障最大的提醒:公司的“备用方案”不能还是另一个微软软件
Microsoft 365如今拥有超过4亿商业付费用户,全球大量政府部门、学校和企业都依靠同一套系统处理邮件、会议、文件和日历。
平时这种统一生态确实非常方便。
Outlook收到邮件,可以直接创建Teams会议;SharePoint里的文件可以通过Microsoft 365共同编辑,Copilot又可以进一步读取相关工作内容。
但所有工具连接得越紧密,一个底层故障产生的连锁反应也可能越大。
这次事故里最有意思的现象之一,就是不少机构最后不得不重新拿起电话。
日本外务省让公众打电话,Euronext让上市公司打电话,Maersk给客户留下当地办公室电话号码,澳大利亚学校也要求家长改用电话联系。
这些都说明真正有效的Business Continuity Plan,不能只是在Teams坏掉以后改用Outlook,因为它们可能依赖同一套基础设施。
企业和学校真正需要考虑的是:如果公司邮箱、聊天、文件和日历同时无法访问,是否还有独立的联系方式、紧急名单以及不依赖同一云平台的数据备份。
十二、一场邮箱故障,让全球再次看到自己到底有多依赖“云”
到11月13日至14日,包括Outlook和Microsoft 365在内的大部分受影响服务已经陆续恢复,OpenAI和Anthropic的Microsoft连接器也随后恢复正常。
但这场持续超过一天的事故,真正留下的问题可能比“Outlook什么时候修好”更加值得关注。
过去几年,AWS、Cloudflare以及Microsoft等大型云服务商都曾发生过大规模故障。
这些公司的系统平时看不见,却支撑着办公室邮件、学校网课、政府服务、银行通信甚至越来越多AI功能。
当一切正常的时候,人们很容易把云服务理解成一种随时都会存在的基础设施。
直到某一天,一个服务器健康检查组件或者网络配置出现问题,全世界不同国家的办公室同时发现:
邮件发不出去,会议进不去,文件打不开,AI也读不到工作资料。
而这次Microsoft 365全球故障最现实的一课或许就是——数字化办公可以全部上云,但真正重要的工作,最好永远准备一个不依赖同一片“云”的备用出口。